La valeur d’un projet de consolidation, d’intégration ou d’analyse ne tient plus seulement à la donnée rassemblée : elle tient au contexte qui permet à un humain, ou à un agent IA, d’ en tirer des réponses justes.
Longtemps j’ai considéré que les projets de consolidation de métadonnées était trop lourd. Quand il s’agit d’agréger les données de 20 ERPs et qu’en plus on doit aussi rassembler, mettre en qualité les métadonnées : on peut vite être découragé. Et l’on préfère se concentrer sur l’essentiel.
Un agent sans contexte se trompe avec aplomb
Depuis l’arrivée de l’IA générative nous avons tous appris le mot « hallucination« .
Nous avons posé les mêmes questions d’analyste à un agent IA, avec ou sans le catalogue de métadonnées de l’entreprise. Sans catalogue, il calcule juste, mais il répond à côté dès que la réponse dépend d’une règle que les données ne désignent pas distinctement.
Le cas d’usage : un détaillant en ligne, ses commandes, clients, factures et remboursements dans Dremio, décrits dans OpenMetadata (glossaire, propriétaires, produits de données, contrat de données, articles, mémoires). L’agent est Claude Code, relié au catalogue par MCP. Nous avons ajouté des pièges ordinaires : une table de factures TTC homonyme des commandes HT, une archive périmée, un ancien référentiel clients.
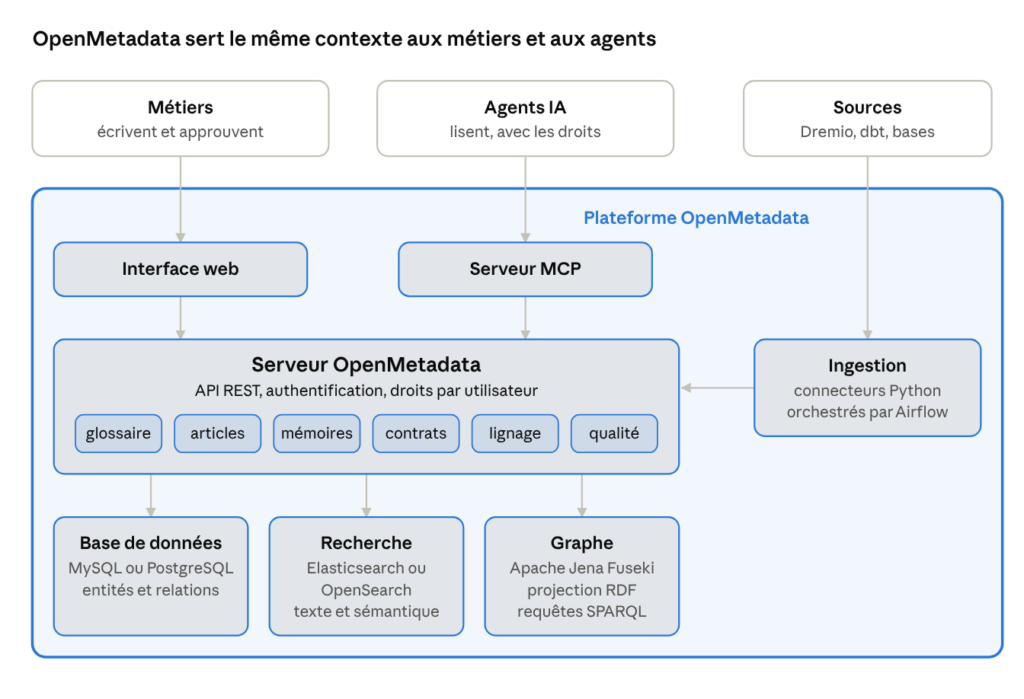
architecture OpenMetadata · 4 niveaux
Les métiers passent par l’interface web, les agents par le serveur MCP : tous deux s’adressent au même serveur, qui stocke les entités en base, les indexe pour la recherche et projette le graphe RDF, pendant que l’ingestion y verse les métadonnées des sources.
Ce que l’agent fait très bien seul :
- retrouver les tables, lire le SQL des vues, reconstituer le lignage ;
- écrire des jointures quand les colonnes portent des noms clairs ;
- déduire qu’une facture est TTC en la comparant à la commande.
Ce qu’il ne peut pas savoir sans contexte, et qu’il remplace par une hypothèse plausible :
- la règle de l’entreprise : il applique la TVA suisse de 8,1 % là où l’entreprise est française et le taux de la TVA est de 20 % ;
- la confiance : il présente un chiffre au comité sans vérifier le contrat ni la date de clôture du mois ;
- la responsabilité : il ignore qui possède une donnée et qui valide un chiffre ;
- la protection : il exporte des emails sans signaler qu’ils sont des données personnelles sensibles.
Aucune de ces erreurs ne se voit dans le résultat. C’est ce qui les rend coûteuses.
Ce que chaque couche de contexte apporte
OpenMetadata fournit différents concepts afin de confectionner un graphe de connaissance fin :
- Fiches d’actifs (couche catalogue) : chaque table, colonne, vue ou pipeline a une description, des tags, un propriétaire et un domaine.
- Domaines et produits de données (catalogue) : ils regroupent les actifs par périmètre métier et disent qui en répond.
- Lignage (catalogue) : il indique d’où vient chaque table et chaque colonne, reconstitué depuis le SQL des vues et des traitements.
- Tests et profilage (catalogue) : ils montrent l’état de qualité d’une table et ses derniers résultats.
- Classifications (catalogue) : des étiquettes comme « donnée personnelle » qui signalent ce qu’il faut protéger.
- Contrats de données (catalogue) : ce que le producteur garantit sur le schéma, la qualité et la fraîcheur.
- Glossaire (couche contexte) : les termes métier, leur définition, leurs synonymes et les colonnes qu’ils qualifient, avec un statut d’approbation.
- Articles (contexte) : des textes libres qui expliquent une règle ou un usage, par exemple la clôture d’un mois.
- Mémoires (contexte) : des règles courtes, servies aux agents une fois approuvées.
- Graphe de connaissances (couche graphe) : la projection RDF de tous ces objets et de leurs liens, interrogeable en SPARQL.
Brancher le catalogue fait passer l’agent de 0,74 à 0,93 ; les règles d’analyse écrites pour lui (des skills) le portent à 0,95. Scores de 0 à 1, moyenne de 540 réponses (27 questions, français et anglais, 2 répétitions), notées sur une grille fixe.
| Ce que l’agent a en plus des données | Questions métier (27) | Questions en SQL (11) |
|---|---|---|
| Rien (base de données seule) | 0,74 | 0,82 |
| Catalogue : recherche, fiches, lignage, qualité | 0,93 | — |
| + Contexte : glossaire, articles, mémoires | 0,94 | 0,91 |
| + Graphe de connaissances | 0,93 | — |
| + Skills d’analyse | 0,95 | 0,95 |
Trois lectures :
- Le saut vient du catalogue. Sur la gouvernance, la qualité et les règles métier, l’agent passe de 0 à 0,56 sans catalogue, à 0,88 à 1 avec le catalogue.
- Les skills rendent l’agent prudent. Il vérifie contrats et règles de publication avant de répondre : « puis-je présenter ce chiffre au comité ? » passe de 0,17 à 0,75.
- Un petit modèle suffit quand le contexte est là. Avec tout le catalogue, Claude Haiku obtient 0,96 et Claude Opus 1,00, pour un coût par question 35 fois plus faible. Sans catalogue, tous deux tombent à 0,23.
Le graphe de connaissances (RDF, SPARQL) n’a rien changé, faute d’avoir servi : sur un schéma aux noms explicites, l’agent trouve ses jointures sans lui. Avec notre « petit cas d’usage et ses quelques tables », l’apport du graphe de connaissance reste à mesurer. Lorsque les noms de colonnes, noms de tables trop peu descriptif, comme dans un progiciel de gestion ancien ou dans un lakehouse très large le graphe de connaissance joue plus son rôle. Une seule requête sur le graphe a par exemple montré où un identifiant client, donnée personnelle, se propageait en aval sans y être signalé.
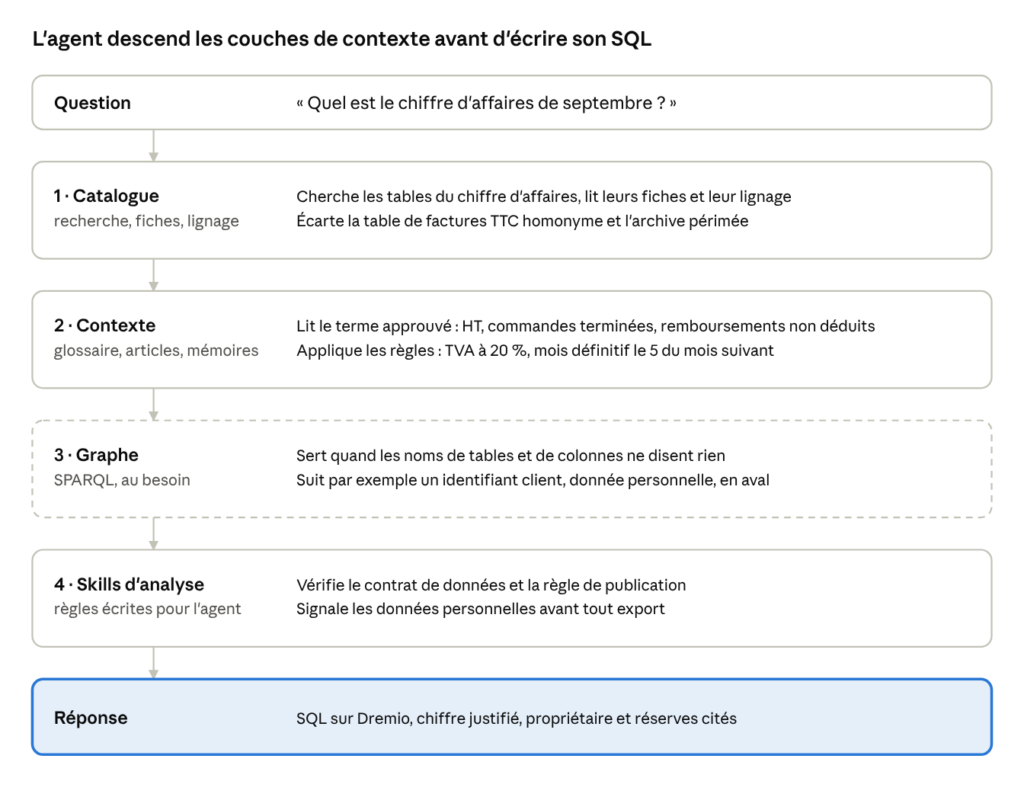
parcours de l’agent · 4 couches de contexte
L’agent passe par chaque couche dans l’ordre et n’écrit sa requête qu’une fois le sens des mots et les règles connus ; le graphe n’intervient que si le catalogue ne suffit pas.
La valeur se déplace : de la donnée consolidée au contexte gouverné
Pendant vingt ans, la valeur d’un projet data se mesurait à la donnée rassemblée : entrepôt, lac, modèle en étoile, tableaux de bord. L’IA change l’équation. Un agent sait déjà écrire le SQL ; ce qu’il ne sait pas, c’est ce que l’entreprise entend par ses mots.
Or ce sens ne se trouve pas dans les données. Il tient dans :
- des acceptions : « chiffre d’affaires » hors taxes, commandes terminées, remboursements non déduits ; « client actif » sur la période ;
- des règles : un mois est définitif le 5 du mois suivant ; telle personne valide les chiffres du comité ;
- des responsabilités : qui possède une donnée, quel contrat la garantit, quel incident l’a touchée ;
- des distinctions fines : deux « montants », deux « TVA », deux tables presque jumelles dont une est périmée.
Plus l’organisation compte de domaines, plus ces nuances se multiplient, et plus une réponse plausible a de chances d’être fausse. Consolider les métadonnées coûte autant que consolider les données. Mais c’est désormais ce travail qui rend l’interrogation des données en libre-service et les agents fiables : la donnée est la matière première, le contexte en est le mode d’emploi.
Où tenir ce contexte
Le contexte doit se trouver là où les métiers peuvent l’écrire et où les agents peuvent le lire. Les options courantes ne réunissent jamais les deux.
| Où | Les métiers peuvent-ils l’écrire ? | Les agents peuvent-ils le lire ? | Relié aux données réelles ? |
|---|---|---|---|
| Dépôt Git (YAML, Markdown) | Non, outil de développeur | Oui | Non, à la main |
| Wiki d’équipe | Oui | Mal, texte libre | Non |
| Base de graphe (Neo4j…) | Non, projet technique | Oui, si on la modélise | À construire |
| Base vectorielle (Milvus…) | Non | Oui, par similarité | Non |
| Plateforme de métadonnées (OpenMetadata) | Oui, dans l’interface | Oui, par MCP | Oui, par l’ingestion |
Une plateforme de métadonnées comme OpenMetadata réunit ce que les autres séparent :
- les métiers écrivent le glossaire, les articles et les mémoires dans l’interface, avec un statut d’approbation ;
- la plateforme embarque déjà le graphe (projection RDF sur Apache Jena Fuseki) et la recherche sémantique : rien à exploiter à côté ;
- l’ingestion relie ce contexte aux tables, colonnes, requêtes et tests réels ;
- les agents le lisent par le protocole MCP, avec les droits de l’utilisateur.
Git garde sa place pour la part structurante qui se versionne : contrats de données (ODCS), produits de données (ODPS), glossaire de base. Un wiki peut rester une source à importer, pas la référence.
Le cercle vertueux de l’ingénierie augmentée
Le même contexte qui guide l’analyste guide aussi l’agent qui construit : il interroge le catalogue avant de créer un flux, une table ou une vue, puis son travail y revient décrit, sous contrat et observé.
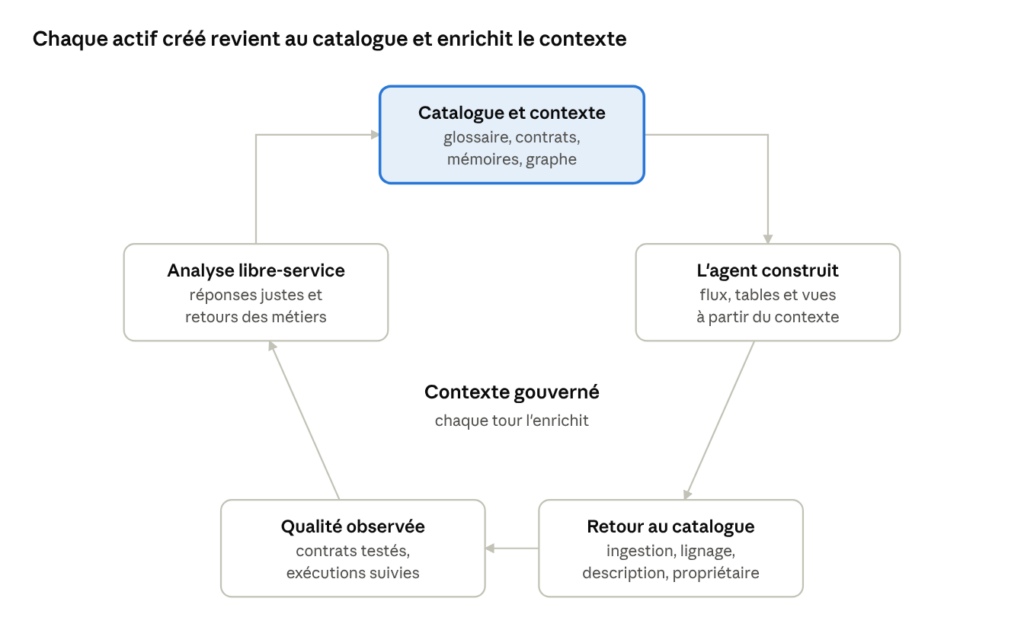
cercle vertueux · 5 étapes
C’est ce retour systématique qui rend le cercle vertueux : sans lui, chaque nouvel actif ajoute du bruit que le prochain agent devra deviner. On comprend l’importance de la gouvernance de ces métadonnées. Tout comme on a le maillage des données, tout comme on a le maillage des métadonnées.
OpenMetadata gestion contexte, qualité des réponses, repenser le cycle de vie des projets Data et IA.
Ce qui fait tenir le dispositif : un processus, pas un outil
Un contexte non entretenu devient un wiki périmé, et un agent qui s’y fie se trompe avec encore plus d’assurance. La valeur du projet tient donc autant au processus qu’à la plateforme :
- Qui écrit. Chaque domaine porte ses définitions, ses contrats et ses mémoires, comme dans un maillage de données.
- Qui approuve. Une mémoire ou un article n’est servi aux agents qu’une fois approuvé ; OpenMetadata gère ces statuts (brouillon, approuvé, archivé).
- Quand cela périme. Une règle changée doit retirer l’ancienne mémoire, sinon l’agent cite les deux.
- Comment cela revient. Chaque actif créé par une chaîne de traitement revient au catalogue avec sa description, son propriétaire et son contrat.
Le coût se contient en avançant domaine par domaine : le gain est immédiat sur le périmètre documenté, sans attendre de tout couvrir.
Limites de l’expérience
Ces chiffres donnent une direction, pas une mesure à l’échelle d’une grande organisation.
- Un cas petit et fictif : une douzaine de tables, trois domaines ; plusieurs catégories de questions saturent à 1.
- Une version non publiée : les outils MCP du graphe n’existent que dans la branche principale d’OpenMetadata (octobre 2026).
- Des mémoires simulées : en version libre, l’outil de mémoire ne sert que les mémoires extraites de documents par un LLM branché sur la plateforme ; nous les avons posées comme si l’extraction avait eu lieu.
- Un juge automatique : un LLM note les réponses sur une grille fixe, contrôlé par un second modèle sur les cas imparfaits ; les questions en SQL sont notées par exécution, en comparant le résultat à une requête de référence.
- Un trou constaté : aucun outil MCP ne donne l’historique des incidents de qualité résolus.
Le banc complet (données, contexte, questions, grilles, lanceur) tient dans quelques scripts et se rejoue en une heure pour moins de 15 dollars avec un petit modèle.
2026 marque un tournant quant à la manière dont Synaltic gère les projets de données. La richesse des métadonnées, l’exploitation des agents IA pour soutenir le cycle de vie des projets, la créativité et l’expertise des consultants Synaltic s’articulent pour re-dessiner les processus de vos activités de consolidation et d’intégration de données.

Sections commentaires non disponible.