Alternatives à Databricks en 2026 : la grille de lecture souveraineté et Apache Iceberg (2/5)
Dans un groupe industriel international où les data scientists travaillaient sur Databricks, notre data engineer industrialisait les flux qu’ils lui apportaient.
Cette scène de terrain suggère qu’une plateforme devient difficile à quitter à l’industrialisation, quand le pipeline remplace le notebook. Dans le premier, consacré à Snowflake, nous avons posé une grille à trois niveaux de contrôle et montré qu’une société de droit américain ne peut rien garantir face au Cloud Act, quoi qu’en dise le contrat. Nous ne refaisons pas cette démonstration ici. Nous l’appliquons à un cas plus subtil, parce que Databricks a construit sa réputation sur l’ouverture.
Ce billet part de l’article de Dremio 19 Databricks Alternatives and Competitors (mai 2026). Nous en avons gardé l’essentiel, retiré ce qui n’intéresse pas un lecteur français, et ajouté ce que l’auteur américain ne pouvait pas écrire.
Ce que l’article américain ne vous dit pas
Trois choses.
La première :
Databricks n’apparaît pas, dans les catalogues que nous avons consultés, ni chez S3NS ni chez Bleu. BigQuery est disponible dans le catalogue qualifié de S3NS depuis décembre 2025, et Fabric pourra un jour l’être via Bleu. Même si l’on voulait garder le plan de contrôle dans Databricks et le plan de données chez l’un des fournisseurs cloud suscité, ce montage ne permetrait pas de bénéficier de la protection SecNumCloud. Pour une administration d’État, un opérateur d’importance vitale ou toute organisation qui doit héberger certaines données sur un cloud qualifié SecNumCloud, Databricks est donc, à ce jour et à notre connaissance, hors périmètre pour ces données. C’est un fait de catalogue, sans jugement sur la qualité du produit. Il ne concerne pas DORA, qui n’impose ni localisation ni cloud qualifié : nous y revenons plus bas.
La deuxième :
Databricks est une société privée. Contrairement à Snowflake, elle ne publie ni rapport annuel ni facteurs de risque auprès de la SEC. Personne ne peut lire, dans un document opposable, ce que Databricks pense de la façon dont ses clients optimisent leur consommation. Les seules sources sur les coûts sont des cabinets FinOps, des blogs de concurrents et des témoignages anonymes. Nous les traiterons comme telles.
La troisième :
C’est le cœur du billet : Databricks a rejoint Apache Iceberg en 2025, ce qui est une bonne nouvelle, mais l’a fait d’une façon qui mérite d’être lue ligne à ligne dans sa documentation.
Databricks en 2026, sans caricature
Databricks a inventé le mot “lakehouse” et l’a rendu crédible. Pour de la data science lourde, de l’entraînement de modèles, des pipelines Spark complexes, il n’existe pas de plateforme intégrée plus complète : notebooks, MLflow, orchestration, gouvernance, tout est là, et l’expérience développeur est excellente. Delta Lake, son format de table, est un projet de la Linux Foundation, sous licence Apache. Unity Catalog, son catalogue, a été ouvert en 2024. Sur le papier, c’est la plateforme la plus ouverte du marché.
Le revers tient en trois points.
La double facture. Databricks facture le calcul dans sa propre unité, le DBU, à la seconde. Votre fournisseur cloud facture séparément les machines virtuelles, le stockage et la sortie réseau qui font tourner ces DBU. Aucune des deux factures ne tient compte de l’autre. Les cabinets FinOps qui accompagnent des migrations Databricks convergent sur un constat : les équipes budgètent le tarif DBU affiché sur le site, puis découvrent que l’infrastructure sous-jacente représente entre 40 et 60 % du coût total. Le taux de consommation de DBU varie lui-même d’un facteur trois à quatre selon qu’un traitement tourne en job planifié ou dans un notebook interactif (Notre expert me fait savoir que par défaut les notebooks interactifs coûtent 0.55 $ DBU et 0.15 $ si on l’exécute en tant que job), et les éditions Premium et Enterprise multiplient encore le tarif unitaire. Rien de tout cela n’est caché. Tout est difficile à prévoir. Le Cigref fait le même constat pour le cloud public en général : un manque de prédictibilité des coûts, et pour difficulté principale d’anticiper le paiement à l’usage.
Spark comme centre de gravité. Databricks a été fondé par les créateurs de Spark, et la plateforme reste conçue autour de lui. C’est une force pour les traitements distribués. C’est une dépendance pour tout le reste : de la BI interactive sur Spark coûte plus cher et répond moins vite qu’un moteur conçu pour la requête, et vos équipes accumulent une expertise Spark qui vaut moins hors de Databricks qu’à l’intérieur.
La gouvernance comme point d’ancrage. C’est le point qui a changé, et celui que nous détaillons.
Le mécanisme : Iceberg oui, mais par Unity Catalog
En juin 2025, Databricks a annoncé la prise en charge complète d’Apache Iceberg dans Unity Catalog, avec une implémentation native de l’API REST Catalog. Un moteur externe, Trino, Flink, Spark, DuckDB, Dremio, peut lire et écrire des tables Iceberg gouvernées par Unity Catalog. Le communiqué parlait d’« éliminer le verrouillage par le format de table ».
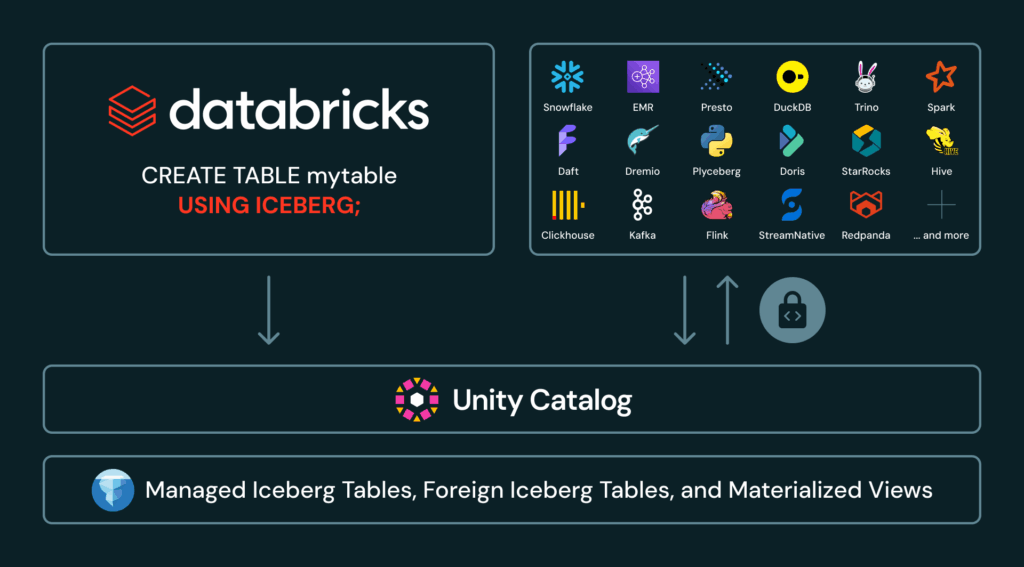
C’est vrai, et c’est incomplet. La documentation Databricks précise que les tables Iceberg managées ne peuvent être créées que si l’optimisation prédictive est activée, et que des propriétés comme le chemin d’écriture des données et le fournisseur d’emplacement sont gérées par Unity Catalog et ne peuvent pas être fixées manuellement. Une table Iceberg managée dans Unity Catalog n’a pas de clause LOCATION : Databricks décide où vivent les métadonnées. Onehouse, qui est un concurrent et doit être lu comme tel, a résumé la situation dans un titre : le support Iceberg de Databricks a un hic, il s’appelle Unity Catalog.
Autre limite, écrite dans la documentation Databricks : les moteurs Iceberg externes ne peuvent pas lire les vues définies dans Unity Catalog. L’API REST rend les tables disponibles, pas les vues. Or une vue porte de la logique métier. Depuis Iceberg 1.11.0 (19 mai 2026), le protocole REST sait enregistrer une vue à partir de ses métadonnées, et le migrateur de catalogues d’Apache Polaris, dans sa version 1.1.0 publiée le 28 septembre 2026, peut déplacer les vues en masse. Encore faut-il que le catalogue de départ les expose au format Iceberg, ce qu’Unity Catalog ne fait pas d’après sa documentation. Vos vues sont donc à recréer, à partir de leur SQL, dans le catalogue cible, et à vérifier : le projet Iceberg ne traduit pas les dialectes SQL d’un moteur à l’autre, et une vue écrite pour Spark peut demander une réécriture pour Trino.
Traduisons en termes de notre grille. Avec Delta Lake, votre dépendance était au format : ouvert, mais lisible par moins de moteurs qu’Iceberg. Avec Iceberg via Unity Catalog, la dépendance s’est déplacée d’un cran vers le haut. Le format est désormais totalement interopérable, et c’est le catalogue, c’est-à-dire l’endroit où sont déclarées vos tables, vos droits d’accès, vos lignages, qui devient la couche que vous ne pouvez pas déplacer sans réécriture. Le catalogue est la nouvelle table. Et Databricks a investi massivement pour que Unity Catalog soit le plus complet du marché, précisément parce que c’est là que se joue la rétention.
Il faut être juste : Snowflake fait exactement la même chose avec Horizon, et Google avec son Lakehouse runtime catalog. Tous les grands ont compris que le format était perdu comme argument de captivité et se sont repliés sur le catalogue. La différence, c’est que Databricks le fait en se présentant comme le champion de l’ouverture.
La grille appliquée à Databricks
Rappel des trois niveaux du premier billet : A, format ouvert et déployable chez vous ou chez un hébergeur qualifié ; B, format ouvert mais service opéré sous juridiction non européenne ; C, format propriétaire.
Databricks est en B, et y reste quelle que soit la configuration : le plan de contrôle est opéré par Databricks, nous n’avons trouvé aucune version installable sur votre Kubernetes, et il ne figure dans aucun catalogue de services qualifiés consulté. Vos données sont en Delta ou en Iceberg sur votre propre stockage objet, c’est le côté ouvert. Votre catalogue est chez Databricks, c’est le côté captif. La porte de sortie existe, elle donne sur vos fichiers Parquet ; il faudra reconstruire le catalogue derrière.
Databricks et DORA : une démarche publiée, une question sur la sortie
Databricks n’est pas muet sur DORA. Deux de ses employés ont publié une démarche, qui s’appuie sur un livre blanc de décembre 2024 : reprise après sinistre entre régions, gestion des incidents, chiffrement et connectivité privée, responsabilité partagée, Unity Catalog pour les accès, l’audit et le lignage. C’est un document d’éditeur, et nous ne l’avons lu que dans sa version Medium. Il ne contient pas le mot « sortie ». Or l’article 28, paragraphe 8, de DORA demande à l’entité financière une stratégie de sortie, documentée, pour les services qui soutiennent des fonctions critiques ou importantes. Continuer à fonctionner chez le prestataire et pouvoir le quitter sont deux obligations distinctes, et la démarche publiée traite la première. Sur la seconde, le catalogue pèse : celui que l’éditeur présente comme l’outil de conformité est aussi celui dont les vues ne sont pas lisibles par un moteur externe. C’est notre lecture, pas celle de l’éditeur. DORA n’interdit pas Databricks. Il demande de pouvoir documenter comment on en part.
Huit alternatives, par niveau de contrôle
Le premier billet contient un tableau de treize alternatives valable pour toute la série. Nous ne retenons ici que celles qui répondent à ce que les organisations demandent à Databricks : du Spark, du lakehouse, de la data science.
1. Apache Spark et Iceberg sur votre Kubernetes (niveau A). L’assemblage de référence. Spark tourne sur n’importe quel cluster, Iceberg sur n’importe quel stockage objet, un catalogue REST (Apache Polaris, Lakekeeper, Nessie) fait le lien. Vous perdez les notebooks intégrés et MLflow managé, que vous pouvez réinstaller vous-même, et vous gagnez la totalité du contrôle. C’est un métier, et c’est le nôtre.
2. IOMETE (niveau A). Le même assemblage, packagé : Spark, Iceberg, Kubernetes, catalogue REST, contrôle d’accès, maintenance automatisée des tables, déployable sur site, chez un hébergeur souverain ou en environnement isolé du réseau. Selon l’éditeur, il n’opère aucun plan de données. C’est l’alternative la plus proche de Databricks que nous ayons identifiée pour un déploiement chez l’hébergeur de votre choix, avec la même réserve que dans le premier billet sur la jeunesse de l’éditeur.
3. Dremio sur site (niveau A). Pas un remplaçant de Spark, mais un remplaçant de l’usage le plus coûteux de Databricks : la BI et le SQL interactif. Dremio, nativement Iceberg, déployé sur votre Kubernetes, sert les tableaux de bord sans Spark. Le rachat par SAP ne change rien à cette configuration, comme nous l’avons expliqué dans le premier billet.
4. Trino, ou Starburst Enterprise (niveau A). Même logique que Dremio, avec une fédération de sources plus large. Trino lit Iceberg et Delta. Beaucoup d’organisations gardent Databricks pour la data science et déplacent la BI sur Trino, ce qui divise la facture DBU sans migration.
5. Cloudera Data Platform (niveau A). Spark, Iceberg, Hive, Impala, sur site. Moins moderne, plus lourd, mais c’est une plateforme complète Spark-Iceberg qui s’installe dans un datacenter que vous maîtrisez.
6. Apache Flink (niveau A). Pour ce que Databricks appelle le streaming et fait avec Spark Structured Streaming. Flink écrit nativement dans Iceberg, avec des garanties exactly-once, et tourne sur Kubernetes. Un flux CDC Debezium, Kafka, Flink, Iceberg remplace une part importante des pipelines Databricks de type Delta Live Tables.
7. Snowflake (niveau B, ou C). Le concurrent frontal, traité dans le premier billet. Moins bon en data science, meilleur en simplicité SQL. Même juridiction, même niveau de contrôle, un catalogue captif qui s’appelle Horizon au lieu de Unity.
8. Google BigQuery via S3NS (niveau C, souverain). Le seul entrepôt d’hyperscaler disponible dans un cloud qualifié SecNumCloud. Format propriétaire, moteur captif, mais protection juridique effective. Nous lui consacrons le troisième billet.
Le chemin, pas le grand soir
Le déplacement de la captivité vers le catalogue est exactement le mécanisme que nous décrivions à Subsurface 2025 dans Escaping the Hadoop Trap : chaque génération de plateforme libère une couche et en verrouille une autre. Hadoop avait ouvert le stockage et verrouillé le format ; les entrepôts cloud ont ouvert le format et verrouillent le catalogue. La réponse ne change pas : traiter le stockage, le format, le catalogue et le moteur comme quatre choix indépendants, et vérifier que chacun peut être remplacé sans toucher aux trois autres. Les étapes qui suivent appliquent cette règle à Databricks.
Étape 1. Activez Iceberg dans Unity Catalog et créez vos nouvelles tables au format Iceberg. Databricks le permet, avec les contraintes décrites plus haut. Vos fichiers deviennent lisibles par les moteurs qui implémentent la spécification Iceberg.
Étape 2. Sortez la BI de Spark. Branchez Trino ou Dremio en lecture sur vos tables Iceberg, via l’API REST de Unity Catalog, et basculez vos tableaux de bord. C’est l’étape qui fait baisser la facture, et elle prouve la réversibilité.
Étape 3. Dupliquez le catalogue. Déclarez vos tables dans un catalogue REST que vous opérez, Polaris ou Lakekeeper, en parallèle de Unity Catalog. Les tables, pas les vues : celles-ci sont à recréer dans le catalogue cible. Le jour où vous voulez partir, le catalogue est déjà là. Le jour où vous voulez rester, vous négociez avec une porte de sortie ouverte.
Étape 4. Pour les données sensibles au sens de la doctrine de l’État, ou qu’un client exige chez un hébergeur qualifié, déplacez stockage et catalogue chez un hébergeur qualifié, et faites tourner le Spark correspondant sur son Kubernetes. Le reste de vos traitements peut rester sur Databricks.
Cinq questions à poser à votre DSI cette semaine
- Quelle part de nos tables Databricks est au format Iceberg, et quelle part reste en Delta ?
- Quelle part de notre facture DBU sert à de la BI ou du SQL interactif, plutôt qu’à de la data science ?
- Si Databricks disparaissait demain, combien de temps faudrait-il pour reconstituer notre catalogue, nos droits d’accès et nos lignages ailleurs ? Pour une entité financière, c’est la question de l’article 28, paragraphe 8, de DORA, et la stratégie de sortie doit y répondre par écrit.
- Quelles données de notre lakehouse relèvent de la doctrine de l’État sur les données sensibles, ou d’une exigence client d’hébergement qualifié, et avons-nous une réponse pour elles sachant que Databricks n’apparaît dans aucun catalogue de services qualifiés consulté ?
- Avons-nous lu la documentation Iceberg de Databricks, ou seulement son communiqué de presse ?
Le format est libre, le catalogue ne l’est pas encore. Ne pariez pas sur les intentions de l’éditeur. Pariez sur la gouvernance du format, et regardez qui gouverne le catalogue.
Sources
- Charly Clairmont (Synaltic), Escaping the Hadoop Trap: Apache Iceberg, the long-term technical debt shield, Subsurface 2025, https://youtu.be/0buykj29KbY
- Dremio, 19 Databricks Alternatives and Competitors, mai 2026.
- Databricks, communiqué Databricks Eliminates Table Format Lock-in, Data + AI Summit, 11 juin 2025.
- Databricks, documentation What is Apache Iceberg in Databricks? (limitations des tables Iceberg managées) et Access Databricks tables from Apache Iceberg clients, consultées en septembre 2026.
- Databricks, documentation What is Apache Iceberg in Databricks? (les moteurs externes ne peuvent pas lire les vues), consultée en septembre 2026 : https://docs.databricks.com/aws/en/iceberg/
- Apache Iceberg, notes de la version 1.11.0, 19 mai 2026 : https://iceberg.apache.org/releases/ ; Apache Polaris, Iceberg Catalog Migrator 1.1.0, 28 septembre 2026 : https://github.com/apache/polaris-tools/releases/tag/apache-polaris-iceberg-catalog-migrator-1.1.0
- Onehouse, Databricks Iceberg Support Has a Catch. It’s Called Unity Catalog, 11 juin 2026 (source concurrente).
- DoiT, Tarification Databricks : DBU, éditions et maîtrise des coûts, 2026 ; Amnic, Databricks Pricing Explained, 2026 (sources FinOps).
- Thales / S3NS, communiqué de qualification SecNumCloud 3.2 de PREMI3NS, 18 décembre 2025 (catalogue de services qualifiés).
- Cigref, Stratégies de migration dans le cloud (couverture datée de janvier 2023, pieds de page de janvier 2022), sections 5.1 et 5.3.
- Lukas Grubwieser et Leonie Hollstein (Databricks), How to achieve DORA compliance with Databricks, Medium (source d’éditeur, qui renvoie au livre blanc DORA, Operational Resilience & Beyond de décembre 2024, non lu).
- Règlement (UE) 2022/2554 (DORA), article 28, paragraphe 8 : https://eur-lex.europa.eu/eli/reg/2022/2554/oj?locale=fr
- Liste de développement d’Apache Iceberg, message de Daniel Weeks du 8 septembre 2026 sur les vues : https://mail-archive.com/dev@iceberg.apache.org/msg15040.html
Billet précédent : Quitter Snowflake n’est pas le sujet. Ne plus pouvoir en partir, si. Prochain billet : BigQuery, le seul entrepôt américain qualifié SecNumCloud. Et alors ?

Sections commentaires non disponible.