Ce site stocke des cookies sur votre ordinateur. Nous les utilisons afin de personnaliser votre expérience de navigation ainsi que pour des analyses d'audience.
Alternatives à Microsoft Fabric et OneLake en 2026 : la grille de lecture souveraineté et Apache Iceberg (5/5) Nous en avons rarement entendu du bien. Mais beaucoup d'organisations ont Microsoft.... Lire la suite →
Alternatives à Databricks en 2026 : la grille de lecture souveraineté et Apache Iceberg (2/5) Dans un groupe industriel international où les data scientists travaillaient sur Databricks, notre data engineer... Lire la suite →
Alternatives à Snowflake en 2026 : la grille de lecture souveraineté et Apache Iceberg Dès lors que l’occasion nous a été donnée de travailler avec Snowflake, un de nos clients... Lire la suite →
Ce que disent le Cloud Act, SecNumCloud, la loi SREN, le Data Act, DORA et NIS2, et ce que cela change pour une architecture de données Dans notre série sur... Lire la suite →
Open Kubernetes Data Platform — une réponse aux coûts cachés de l’assemblage. Vue d'ensemble : le modèle OKDP Lecture du schéma. Le Context (centre) distribue une seule fois les paramètres... Lire la suite →
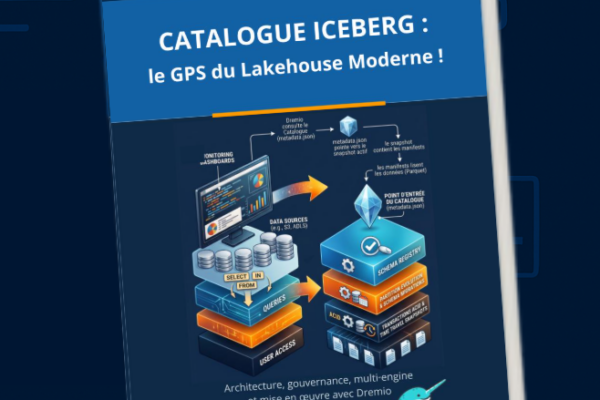
Le Lakehouse moderne repose sur Apache Iceberg™, mais c’est le catalogue qui en détermine vraiment la puissance, l’ouverture… et le degré de dépendance à un fournisseur.Dans ce livre blanc, nous... Lire la suite →
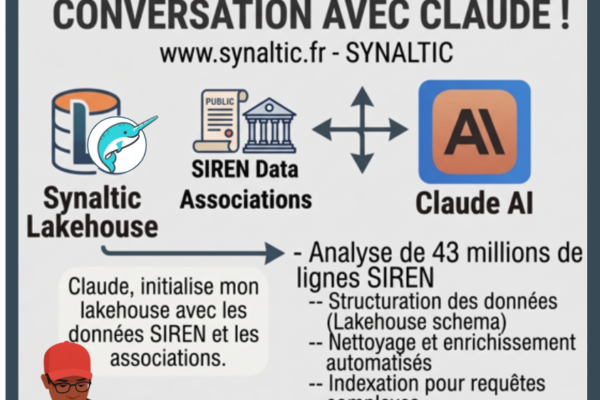
43 millions de lignes SIRENE : initialisation d'un lakehouse "associations" en une conversation avec Claude Et si construire un data lakehouse ne nécessitait plus de connaître par cœur la syntaxe... Lire la suite →
Passer à l'échelle Cet article fait partie de la série « Maillage de données avec Dremio ». Dans l'article précédent, nous avons sécurisé notre plateforme : catalogue structuré, modèle de... Lire la suite →
Gouvernance et catalogue Cet article fait partie de la série « Maillage de données avec Dremio ». Dans l'article précédent, nous avons construit l'architecture technique : le modèle médaillon, la... Lire la suite →