Alternatives à BigQuery en 2026 : la grille de lecture souveraineté et Apache Iceberg (3/5)
Nous n’avons pas déployé BigQuery. Un de nos clients de la grande distribution l’utilise et nous rappelle régulièrement que chaque requête lui coûte quelque chose, ce qui freine l’usage.
Cette remarque d’un client pose la question de ce troisième billet. Que reste-t-il de votre liberté quand la souveraineté est réglée, mais que le modèle de facturation freine l’usage ? Les deux premiers, sur Snowflake puis Databricks, ont montré qu’aucun entrepôt d’hyperscaler ne pouvait garantir l’immunité au Cloud Act sous son propre pavillon. BigQuery est le premier à contourner l’obstacle, par une société française. La différence est réelle, mais elle porte sur la juridiction, pas sur le contrôle du format ni du moteur.
Ce que l’article américain ne vous dit pas
Dremio classe BigQuery parmi les alternatives à Snowflake et à Databricks sans un mot sur la juridiction. Pour un lecteur français, la juridiction est la première information.
Le 17 décembre 2025, S3NS, filiale de Thales en partenariat avec Google Cloud, a obtenu la qualification SecNumCloud 3.2 de l’ANSSI pour son offre PREMI3NS. Le catalogue qualifié comprend une trentaine de services Google, dont Google Kubernetes Engine et BigQuery. S3NS est une société de droit français, entièrement contrôlée par Thales, qui n’a pas à développer de fonctionnalités : elle inspecte les correctifs fournis par Google avant de les répercuter sur une infrastructure indépendante et hermétique par rapport à la plateforme de Google. C’est exactement le montage que nous décrivions dans le premier billet : un opérateur français qui exploite une technologie américaine sans que l’éditeur américain n’en soit actionnaire.
Deux précisions que l’enthousiasme ambiant a tendance à gommer. La qualification porte sur PREMI3NS, pas sur Google Cloud. Un BigQuery ouvert dans la région europe-west9 de Google reste, juridiquement, chez Google. Et le catalogue qualifié est un sous-ensemble : Vertex AI, Cloud Run et Dataproc étaient annoncés pour 2026, pas encore livrés au moment de la qualification. Une architecture qui mélange BigQuery sur S3NS et des services non qualifiés chez Google n’est souveraine que pour la partie qui l’est.
Une réserve vient du Sénat. Dans son rapport de juillet 2025, la commission d’enquête sur la commande publique appelle les administrations à retenir de préférence des solutions reposant sur des technologies intégralement souveraines plutôt que des offres hybrides, associant un opérateur européen et une technologie étrangère, dont la résilience en cas de coupure du lien technologique n’est pas garantie selon plusieurs experts entendus. S3NS est, par construction, un opérateur français sur technologie Google, donc une offre de ce type. Cela ne préjuge pas de son mérite. Cela justifie de ne pas faire de S3NS votre seul point d’appui, et de garder vos tables dans un format qu’un autre moteur sait lire.
BigQuery en 2026, sans caricature
BigQuery est probablement l’entrepôt le plus élégant du marché. Serverless au sens strict : pas de cluster, pas d’entrepôt virtuel, pas de dimensionnement. Vous envoyez une requête, elle s’exécute sur des milliers de machines, vous payez les octets lus. Sur des volumes très importants et des requêtes occasionnelles, personne ne fait mieux. L’intégration avec Vertex AI et Looker est profonde, et BigQuery ML permet d’entraîner des modèles en SQL sans sortir de l’outil.
Le revers est double.
La tarification bouge, et vous ne la contrôlez pas. Annoncée par Google le 29 mars 2023 et entrée en vigueur le 5 juillet 2023, la révision a relevé de 25 % le prix de la requête à la demande dans toutes les régions (de 5 à 6,25 dollars le téraoctet, selon deux cabinets FinOps), et mis fin à la vente des forfaits de slots au profit des « éditions » Standard, Enterprise et Enterprise Plus. Les clients ont eu environ trois mois de préavis. Cette révision illustre ce qu’est un service managé : le fournisseur fixe le prix, vous fixez votre consommation. Sur S3NS, la tarification suit celle de Google avec la marge de l’opérateur ; la qualification protège vos données d’une réquisition, pas votre budget d’une révision tarifaire.
Les requêtes fréquentes coûtent cher. Le modèle à l’octet lu est imbattable pour dix requêtes lourdes par jour et redoutable pour dix mille requêtes légères par heure. Les tableaux de bord qui se rafraîchissent en continu, les API analytiques, les agents IA qui interrogent en boucle : tout ce qui est fréquent et petit consomme des octets à un rythme que les éditions à slots réservés absorbent, au prix d’un engagement.
Le mécanisme : Google a pris Iceberg au sérieux, ce qui change la question
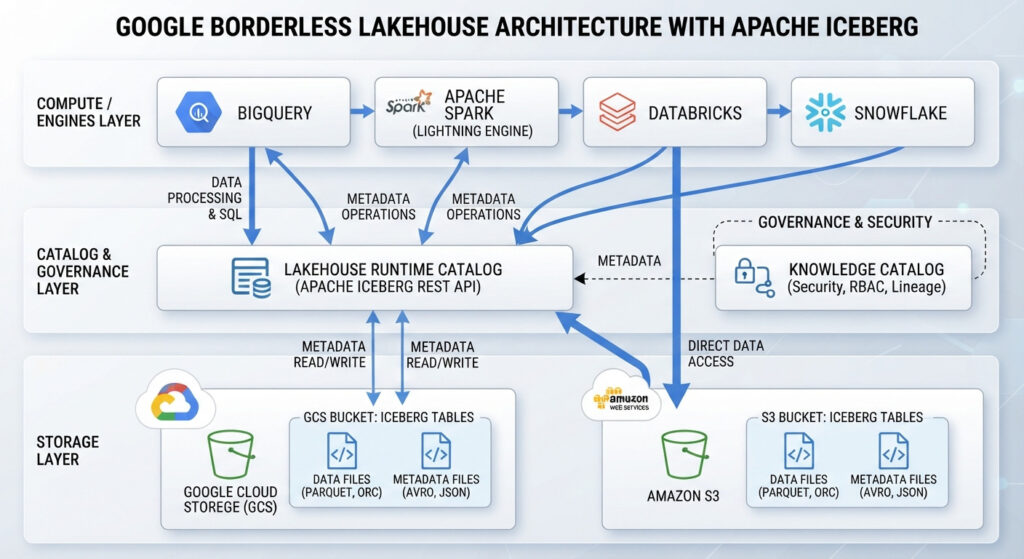
Des trois hyperscalers, Google est celui qui est allé le plus loin. Depuis le 20 avril 2026, BigLake s’appelle « Lakehouse for Apache Iceberg », et BigLake Metastore est devenu le « Lakehouse runtime catalog », qui expose un endpoint Iceberg REST Catalog standard. Google recommande désormais cette voie plutôt que son ancienne intégration Iceberg propriétaire, avec distribution de credentials temporaires aux moteurs externes et réplication inter-régions. Spark, Flink et Trino peuvent créer et gérer des tables Iceberg dans Cloud Storage via ce catalogue, et BigQuery les lit.
Concrètement, vous pouvez aujourd’hui construire sur Google Cloud une architecture où vos tables sont en Iceberg sur Cloud Storage, déclarées dans un catalogue REST standard, et lues à la fois par BigQuery et par des moteurs open source. C’est une architecture de niveau B, la même que Snowflake avec Iceberg ou Databricks avec Unity Catalog, avec une différence : le catalogue REST de Google est présenté comme la voie recommandée, pas comme une compatibilité.
Ce que cela ne change pas : les tables natives BigQuery, celles que l’immense majorité des clients utilisent, restent dans un format propriétaire, dans un stockage géré par Google, interrogeables uniquement par BigQuery. Et sur S3NS, il faut vérifier que le Lakehouse runtime catalog fait partie du périmètre qualifié avant de bâtir dessus.
Deux axes, donc, indépendants l’un de l’autre. L’axe juridique : Google Cloud n’est pas souverain, S3NS l’est. L’axe de réversibilité : BigQuery natif ne l’est pas, BigQuery sur Iceberg l’est en partie. Le quadrant qui compte pour une organisation française est celui qui coche les deux, et il existe : Iceberg sur le stockage objet de S3NS, catalogue REST, BigQuery comme un moteur parmi d’autres.
La grille appliquée à BigQuery
BigQuery natif chez Google : niveau C. Format propriétaire, juridiction américaine.
BigQuery natif sur S3NS : niveau C sur la réversibilité, mais protégé juridiquement. Nous l’appelons « C souverain ». C’est un vrai progrès, et c’est aussi la configuration la plus captive du marché : le jour où vous voulez partir, vous partez de S3NS et de Google en même temps, avec un format que personne d’autre ne lit.
BigQuery sur tables Iceberg, chez Google : niveau B.
BigQuery sur tables Iceberg, sur S3NS, si le catalogue REST est qualifié : le meilleur des deux axes. Nous n’avons pas trouvé, dans la documentation consultée, de confirmation que le catalogue REST du Lakehouse for Apache Iceberg fasse partie du périmètre qualifié de PREMI3NS : à vérifier avec S3NS avant de l’écrire dans un cahier des charges.
Huit alternatives, par niveau de contrôle
1. Apache Iceberg sur le stockage objet de S3NS, ou d’OVHcloud, Scaleway, Outscale (niveau A ou B selon le moteur). L’architecture qui coche les deux axes. Le stockage chez un hébergeur qualifié, les tables en Iceberg, un catalogue REST, et BigQuery, Trino, DuckDB ou Dremio comme moteurs. Le premier billet la décrit en détail.
2. Trino, ou Starburst Enterprise (niveau A). Le remplaçant le plus direct pour les requêtes fédérées et la BI. Trino lit Iceberg, et il lit aussi BigQuery, ce qui permet une transition progressive.
3. ClickHouse (niveau A). Pour ce que BigQuery fait mal : des milliers de requêtes légères par heure. Disponible en managé chez Scaleway. Le profil de coût est l’inverse de celui de BigQuery : cher à la donnée froide, quasi gratuit à la requête.
4. DuckDB (niveau A). Pour les analystes. Lit Iceberg et Parquet sur n’importe quel stockage objet, tient sur un poste de travail. Une part surprenante des usages BigQuery d’une collectivité ou d’une ETI tient dans DuckDB.
5. Dremio sur site (niveau A). Requêtes fédérées, accélération par réflexions, nativement Iceberg. Pour une organisation qui veut un produit plutôt qu’un assemblage, sans quitter son datacenter.
6. StarRocks (niveau A). Analyse multidimensionnelle en dessous de la seconde sur tables Iceberg, pour le temps réel que BigQuery sert au prix fort.
7. Snowflake (niveau B ou C). Le concurrent historique. Premier billet.
8. Databricks (niveau B). Pour la data science et Spark. Deuxième billet. Absent des catalogues de services qualifiés SecNumCloud que nous avons consultés.
Le chemin, pas le grand soir
Les deux axes que nous venons de séparer, juridiction et réversibilité, recoupent la grille de décision que nous avons présentée à Subsurface 2025 dans Escaping the Hadoop Trap : le stockage répond à la question de la juridiction, le format et le catalogue répondent à celle de la réversibilité, et le moteur doit pouvoir changer sans que les trois autres ne bougent. S3NS règle la première case. Iceberg règle les deux suivantes. BigQuery devient alors un moteur, remplaçable, ce qui est la seule position confortable pour un client.
Étape 1. Classez vos données. Celles qui relèvent de NIS2, de DORA, du secret statistique ou d’une exigence de l’État vont sur S3NS. Les autres peuvent rester chez Google ou aller ailleurs. La souveraineté commence par une classification, pas par une migration.
Étape 2. Créez vos nouvelles tables en Iceberg via le Lakehouse runtime catalog, sur Cloud Storage, et laissez BigQuery les interroger. Rien ne change pour les utilisateurs. Vos fichiers deviennent lisibles ailleurs.
Étape 3. Branchez un second moteur en lecture, Trino ou DuckDB, sur ces mêmes tables. Mesurez. Sur les requêtes fréquentes et légères, le second moteur coûtera moins cher que BigQuery ; sur les scans massifs, l’inverse. Vous saurez alors ce que chaque moteur vaut, plutôt que de le supposer.
Étape 4. Négociez avec cette preuve en main. Un client qui peut montrer que ses tableaux de bord tournent sur Trino n’a pas la même conversation avec Google, ni avec S3NS, qu’un client qui ne le peut pas.
Cinq questions à poser à votre DSI cette semaine
- Nos données sensibles sont-elles sur S3NS, ou dans une région Google en France, ce qui n’est pas la même chose ?
- Quelle part de nos tables BigQuery est au format natif, et quelle part en Iceberg sur Cloud Storage ?
- Le Lakehouse runtime catalog est-il dans le périmètre qualifié de PREMI3NS ?
- Quel a été l’impact sur notre budget de la révision tarifaire de juillet 2023, et qu’avons-nous prévu pour la prochaine ?
- Si nous devions quitter Google et S3NS ensemble, combien de nos tables seraient lisibles par un autre moteur le lendemain ?
La qualification SecNumCloud répond à une question : qui peut lire vos données sans votre accord. Elle ne répond pas à l’autre : qui peut vous empêcher de les lire ailleurs. Ne pariez pas sur les intentions de l’éditeur. Pariez sur la gouvernance du format.
Sources
- Charly Clairmont (Synaltic), Escaping the Hadoop Trap: Apache Iceberg, the long-term technical debt shield, Subsurface 2025, https://youtu.be/0buykj29KbY
- Thales, communiqué S3NS annonce la qualification SecNumCloud de son offre Cloud de Confiance PREMI3NS, 18 décembre 2025 ; L’Usine Digitale, 19 décembre 2025 ; Le Monde Informatique, février 2026 (catalogue de services validés et feuille de route 2026).
- Google Cloud, documentation Lakehouse for Apache Iceberg (anciennement BigLake), note de renommage du 20 avril 2026, et Iceberg REST catalog tables, consultées en septembre 2026.
- Google Cloud, New BigQuery editions: flexibility and predictability for your data cloud, 29 mars 2023 (hausse de 25 % du tarif à la demande au 5 juillet 2023) : https://cloud.google.com/blog/products/data-analytics/introducing-new-bigquery-pricing-editions ; DoiT et Adswerve pour le passage de 5 à 6,25 dollars le téraoctet.
- Sénat, rapport n° 830 (2024-2025), commission d’enquête sur la commande publique, juillet 2025 : https://www.senat.fr/rap/r24-830-1/r24-830-115.html
- Dremio, Snowflake Competitors et 19 Databricks Alternatives, mai 2026.
- Sénat, audition de Microsoft France, 10 juin 2025 (voir premier billet).
Billet précédent : Delta Lake est open source. Databricks ne l’est pas. Prochain billet : Microsoft Fabric, ou comment Power BI est devenu une plateforme de données.

Sections commentaires non disponible.