Alternatives à Snowflake en 2026 : la grille de lecture souveraineté et Apache Iceberg
Dès lors que l’occasion nous a été donnée de travailler avec Snowflake, un de nos clients était déjà enchanté avant même que nous ayons écrit une seule requête SQL. Pourquoi un tel sourire ? En tant qu’analyste, nous étions tout autant ravis : nous avions accès à une voiture toutes options.
Nous pouvons comparer notre expérience à celle d’une DSI d’une ETI. Vous avez peut-être vécu la même scène. Snowflake tient toutes ses promesses techniques. Le comité budgétaire se tient en ce début 2026. Au sein de l’ETI l’entrepôt tourne, les analystes sont contents. Et pourtant, deux ans après la migration, la ligne « data cloud » du budget est devenue celle que la direction financière regarde en premier.
Ce billet ouvre une série de cinq. Il part d’un article publié par Dremio en mai 2026, Snowflake Competitors: More Affordable and Open Source Alternatives, qui liste dix-neuf alternatives à Snowflake. Nous en avons gardé douze, celles que vous cherchez vraiment sur un moteur de recherche, nous en avons ajouté une que l’original ignore, et nous les avons réordonnées avec une question que l’article original ne se pose pas : que reste-t-il de votre liberté de choix quand vos données sont hébergées, traitées et cataloguées par une société de droit non européen ?
Souveraineté par les données
Trois choses, dont vous devriez tenir compte dans le choix de votre plateforme de données dans le cloud ou sur site.
- Le Cloud Act ne regarde pas où sont vos serveurs. Il regarde qui contrôle l’entreprise (votre fournisseur). Une région « Paris » chez un fournisseur américain ne vous protège de rien, puisque la loi s’applique à la société mère, pas au datacenter. Snowflake est une société du Delaware. Databricks aussi. Cela ne fait pas d’elles de mauvais fournisseurs. Cela fait d’elles des fournisseurs auxquels une clause contractuelle « données en Europe » ne peut rien garantir.
- En France, le seul référentiel qui matérialise une immunité juridique face à ces lois extraterritoriales est SecNumCloud, la qualification de l’ANSSI. Sa version 3.2 impose que le siège, l’administration et le principal établissement du prestataire soient dans l’Union, et limite la part du capital et des droits de vote détenue par des entités non européennes. Depuis l’arrêté du 12 août 2026, elle est obligatoire pour les administrations de l’État, leurs opérateurs et six groupements d’intérêt public, pour leurs données d’une sensibilité particulière (article 31 de la loi SREN). En dehors de ce périmètre, elle ne s’impose pas : une entreprise privée peut s’en servir comme critère d’achat. À notre connaissance, aucun des grands entrepôts américains n’est qualifié sous son propre pavillon. S3NS (Thales, technologie Google) a obtenu la qualification en décembre 2025 et son catalogue inclut BigQuery, mais pas Snowflake. Bleu (Orange-Capgemini, technologie Microsoft) l’avait engagée sans l’avoir obtenue à la mi-2026. Ces offres qualifient une infrastructure et les services de leur catalogue, pas Snowflake. Les textes sont détaillés, avec leurs limites, dans notre article de référence.
- Et c’est la moins confortable : aucun hébergeur européen ne propose aujourd’hui, avec sa propre technologie, d’entrepôt managé comparable à Snowflake, BigQuery ou Databricks. S3NS fait exception pour BigQuery, avec la technologie de Google. OVHcloud, Scaleway, Outscale et Numspot ont les briques, du stockage objet aux clusters Kubernetes, pas le produit fini. Si vous cherchez « le Snowflake français », vous ne le trouverez pas.
Ces trois constats ensemble déplacent la question. Chercher une alternative à Snowflake, c’est chercher un autre fournisseur à qui confier la même dépendance. La bonne question est plutôt : comment faire pour que le fournisseur, quel qu’il soit, devienne remplaçable ?
Snowflake en 2026, sans caricature
Snowflake a réussi trois choses que peu de plateformes ont réussies. La séparation du calcul et du stockage, qui permet de dimensionner l’un sans toucher à l’autre. Le partage de données entre organisations sans copie, qui a créé de vrais écosystèmes sectoriels. Et une simplicité d’exploitation qui a vidé des équipes entières d’administrateurs de bases de données. Un analyste SQL est productif sur Snowflake en une journée.
Le revers est le modèle de facturation. Vous payez des crédits, consommés par des entrepôts virtuels dont la taille et la durée d’activité déterminent la note. Chaque requête mal écrite, chaque tableau de bord rafraîchi trop souvent, chaque fonction serverless activée sans y penser consomme des crédits.Tous les agents branchés sur Snowflake qui génèrent des requêtes non optimisées (tout du moins au départ) alourdissent la facture.
Nous n’avons pas trouvé de retour d’expérience français, public et chiffré, sur les coûts Snowflake. Les grandes entreprises ne publient pas leurs factures, et ce silence dit quelque chose. Trois sources existent ; elles se complètent :
- La première est comptable.
En août 2023, Instacart a déposé son dossier d’introduction en bourse auprès de la SEC. Le document déclare des paiements à Snowflake d’environ 13 M$ en 2020, 28 M$ en 2021 et 51 M$ en 2022, puis une prévision de 15 M$ pour 2023. Snowflake a publié un correctif : la consommation réelle s’établissait à 28 M$ en 2021 comme en 2022, le pic de 2022 correspondait à des paiements anticipés, et la baisse venait d’une optimisation charge par charge, présentée lors d’une conférence Snowflake comme une réduction des coûts de 50 %. Prenez la version de Snowflake, elle suffit. Un client de 1 000 utilisateurs quotidiens, 200 entrepôts virtuels et 230 millions de requêtes par mois a divisé sa facture par deux sans réduire son usage. La moitié de ce qu’il payait ne servait à rien, et personne ne l’avait vu avant qu’un comité d’audit ne regarde la ligne.
- La deuxième est un aveu.
Dans ses propres publications financières, Snowflake range parmi les risques pesant sur son chiffre d’affaires la mesure dans laquelle ses clients continuent d’optimiser leur consommation, y compris en raccourcissant leurs politiques de rétention des données. Son taux de rétention nette, qui mesure ce que les clients existants dépensent d’une année sur l’autre, atteignait 178 % au 31 janvier 2022. Il est de 125 % à l’automne 2025. Chaque client qui apprend à lire sa facture fait reculer ce chiffre. Snowflake le sait.
- La troisième est collective.
Le Cigref, qui réunit les grandes entreprises et administrations publiques françaises, a publié en janvier 2023 un rapport sur les stratégies de migration dans le cloud nourri des retours de ses membres. Ils y parlent de « dérive » et d’« explosion des coûts » dans le cloud public (p. 33), d’une facture après migration parfois plus élevée qu’avant (p. 36), et de coûts de migration qui dépassent souvent ceux d’un maintien sur site (p. 38). Ce qu’ils décrivent, c’est la difficulté de passer d’une gestion d’actifs logiciels à une tarification à l’usage, avec des dépenses difficiles à identifier et à contrôler (p. 35). Le Cigref ne nomme pas Snowflake. Mais Snowflake est la forme la plus pure de ce modèle : aucun serveur à réserver, des crédits décomptés à la seconde, une facture qui suit l’usage sans plafond par défaut.
Les concurrents avancent des chiffres plus spectaculaires. Dremio parle de coûts dépassant de 200 à 300 % les prévisions ; MotherDuck cite un éditeur SaaS qui a réduit sa facture de plus de 70 % en quittant Snowflake pour DuckDB ; ClickHouse revendique des écarts de trois à cinq fois. Nous les mentionnons pour mémoire, pas comme preuve. Les trois sources précédentes suffisent, et aucune n’a intérêt à noircir le tableau.
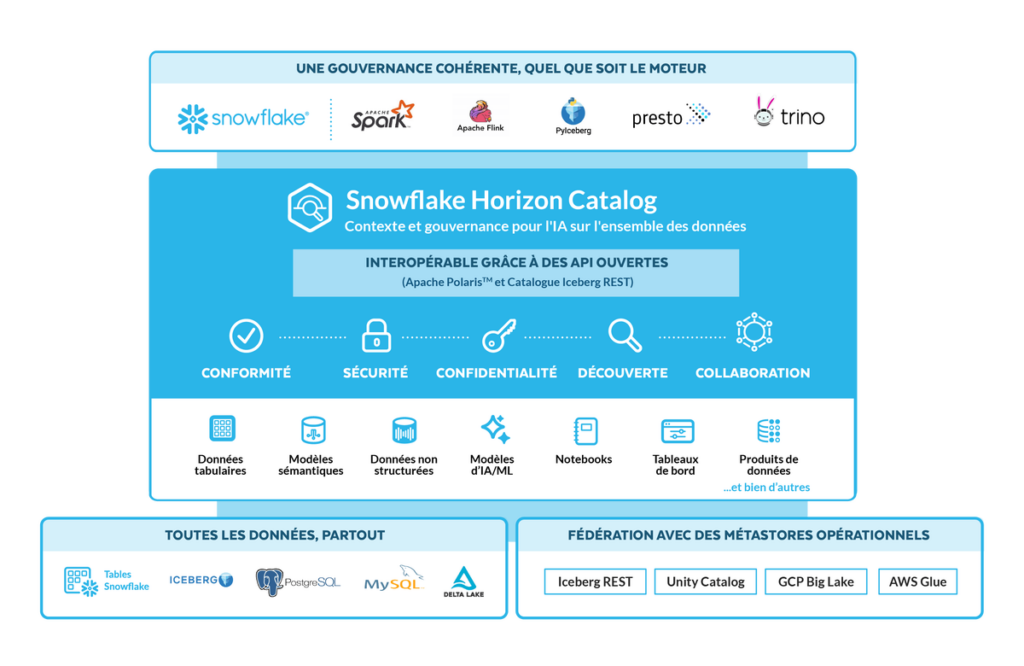
Vient ensuite le point que les articles de comparaison traitent en une ligne et qui mérite un paragraphe. Snowflake a adopté Apache Iceberg. Depuis 2024, vous pouvez créer dans Snowflake des tables Iceberg stockées dans vos propres buckets, et Snowflake a donné à la fondation Apache son catalogue Polaris, devenu Apache Polaris. Concrètement, le format de stockage n’est plus un argument de rétention. Une table Iceberg gérée par Snowflake est lisible, sans conversion de format, par les moteurs qui implémentent la spécification Iceberg et le protocole REST. Deux réserves figurent dans la documentation de Snowflake : seules les tables Iceberg gérées par Snowflake sont accessibles aux moteurs externes par le catalogue Horizon, et les appels à cette API REST sont facturés, à raison de 0,5 crédit par million d’appels, avec une facturation annoncée pour le second semestre 2026. Par ailleurs, Snowflake a aussi montré que les performances de ses tables Iceberg était quasi équivalentes aux tables internes (dans son format propriétaire).
Ce qui reste captif, ce sont trois couches. Le moteur, dont les performances sont excellentes et que vous ne retrouverez pas à l’identique ailleurs. Les fonctions propriétaires, de Snowpark à Cortex, qui n’ont pas d’équivalent portable. Et les habitudes, les scripts, les compétences de vos équipes, qui se sont construites autour de l’interface Snowflake.
Le format était la première couche de dépendance. Elle est tombée. Les trois autres tiennent encore.
Trois niveaux de contrôle
Pour lire la liste qui suit, nous utilisons une grille simple. Elle servira aussi pour les prochains billets de la série.
Niveau A. Format ouvert, et l’outil se déploie sur votre infrastructure ou chez un hébergeur qualifié SecNumCloud. Vous contrôlez la donnée, le moteur et le lieu.
Niveau B. Format ouvert, mais le service est opéré en SaaS par une société sous juridiction américaine. Vous contrôlez la donnée, pas le moteur ni le lieu. La porte de sortie existe, elle est juste chez le voisin.
Niveau C. Format propriétaire. Sortir demande une extraction, une conversion et une revalidation de tout ce qui a été construit dessus.
Snowflake est en C par défaut. Il passe en B si vous basculez vos tables en Iceberg sur votre propre stockage. Ce seul déplacement, sans changer de fournisseur, sans migration, est déjà la moitié du chemin vers la souveraineté. Peu d’organisations le font, parce que personne ne les y pousse.
Treize alternatives, classées par niveau de contrôle
1. Apache Iceberg et un moteur au choix (niveau A)
Iceberg est une architecture, et ouvre la liste parce que le lecteur français doit la comprendre avant les autres. Vos tables au format Iceberg, sur un stockage objet compatible S3 chez OVHcloud, Scaleway, Outscale, IONOS, Cleaver Cloud. Un catalogue Iceberg REST (Apache Polaris, Nessie ou Lakekeeper). Et au-dessus, le moteur qui convient à chaque usage : Trino pour le SQL fédéré, Flink pour le temps réel, DuckDB pour l’analyste, Spark pour le traitement lourd.
Ce que vous y gagnez : aucune couche propriétaire entre vos données et vous. Ce que vous y perdez : le confort d’un produit intégré. Il faut assembler, exploiter, surveiller. C’est un métier, et c’est le nôtre depuis 2023, quand nous avons montré à Subsurface un pipeline Debezium, Kafka, Iceberg alimentant à la fois l’intégration applicative et l’analytique.
2. Trino et Starburst (niveau A pour Trino, B pour Starburst)
Trino est le moteur SQL distribué qui interroge une trentaine de sources sans déplacer les données, sous licence Apache, gouverné par la Trino Software Foundation. Il ne stocke rien, il lit Iceberg nativement, et il tourne sur n’importe quel Kubernetes. Starburst en est la distribution commerciale, avec contrôle d’accès, cache et gouvernance ; sa version SaaS, Galaxy, est américaine. Choisissez Trino seul si vous avez une équipe plateforme, Starburst Enterprise sur votre infrastructure si vous voulez du support sans quitter le niveau A.
3. ClickHouse (niveau A ou B)
Base colonne open source, conçue pour les requêtes analytiques en dessous de la seconde avec une forte concurrence. Coût d’exploitation très bas comparé à un entrepôt cloud. Le projet est ouvert, mais l’éditeur ClickHouse Inc. est américain et son offre managée aussi. La bonne nouvelle : Scaleway a bâti une partie de son offre analytique autour de ClickHouse, ce qui en fait l’un des rares moteurs performants disponibles en managé chez un hébergeur français. Limites : les jointures complexes et les transactions.
4. DuckDB, et MotherDuck (niveau A pour DuckDB, B pour MotherDuck)
DuckDB tient dans un processus, s’installe avec une ligne de Python et lit Parquet, CSV et Iceberg sans serveur. Pour 80 % des PME et pour la plupart des analystes de grands groupes, c’est un remplaçant crédible de Snowflake sur les usages quotidiens. Détail qui compte pour un lecteur européen : DuckDB est développé par une fondation néerlandaise, sous licence MIT. MotherDuck, la version cloud collaborative, est américaine. Limite claire : une seule machine, pas de gouvernance intégrée.
5. Dremio, désormais dans SAP Business Data Cloud (niveau A / niveau B, à suivre)
Le cas d’école de cette série. Dremio est un lakehouse nativement Iceberg, avec un catalogue Polaris et une fédération de requêtes sans copie. Un point que les comparatifs oublient : Dremio existe en logiciel, déployable sur votre propre Kubernetes, sur site ou chez un hébergeur qualifié, sans plan de données chez l’éditeur. Dans cette configuration, il est au niveau A, Synaltic est partenaire certifié de Dremio : lisez ce paragraphe avec ce recul. La version cloud, opérée par l’éditeur, est au niveau B. SAP a finalisé son rachat en juillet 2026 et annonce faire d’Iceberg le socle de Business Data Cloud, et de Polaris son catalogue universel ; ce que devient l’offre sur site dans ce cadre est la question à suivre.
Les précédents invitent à distinguer. Quand Broadcom a racheté VMware, les clients ont vu leurs factures multipliées. Quand SAP a racheté Business Objects en 2008, personne n’a vu sa facture exploser ; en revanche le produit s’est éteint doucement, et les clients ont migré dix ans plus tard, contraints. Quand IBM a racheté HashiCorp, la licence de Terraform avait déjà quitté l’open source, et IBM n’a pas fait marche arrière. Trois échecs, un point commun : le client dépendait d’un standard détenu par un seul acteur.
Il existe un quatrième précédent, sans rachat ni changement de licence : Hadoop. Nous avons vu son cycle complet, la genèse prometteuse, l’ascension rapide, puis, après une douzaine d’années, l’incapacité à s’adapter à l’ère du cloud. Des milliers d’organisations, en France aussi, se sont retrouvées avec des données dans un système que plus personne ne voulait faire évoluer. Nous avons consacré à ce cycle une intervention à Subsurface 2025, Escaping the Hadoop Trap, dont la thèse est celle de cette série : une plateforme de données doit être conçue pour changer de composants, stockage, format de fichier, catalogue, moteur de requête, sans réécrire ses données. Nous tenons Iceberg pour le socle « support à long terme » d’une architecture : sa spécification est publique, gouvernée par la fondation Apache, et implémentée dans plusieurs langages (Java, Python, Rust, Go, C++).
Dremio repose sur Iceberg et Polaris, deux projets de la fondation Apache. SAP ne peut ni en changer la licence, ni les laisser mourir sans que Snowflake, qui a donné Polaris, ne les reprenne. C’est la différence avec Terraform, et c’est pourquoi un client Dremio peut regarder ce rachat avec sérénité, voire avec intérêt : un éditeur européen, membre fondateur de la fondation Eclipse, qui affronte Snowflake et Databricks avec un format Apache. Nous y reviendrons dans le troisième billet.
6. Databricks (niveau B)
Delta Lake est open source, la plateforme ne l’est pas. Databricks a rejoint le mouvement Iceberg et Unity Catalog expose désormais l’API REST Iceberg pour les tables, ce qui rapproche la porte de sortie ; sa documentation précise en revanche que les moteurs Iceberg externes ne peuvent pas lire les vues. Mais le modèle à deux factures (unités Databricks plus infrastructure cloud), la dépendance à Spark et la complexité d’exploitation restent entières. Excellent pour la data science lourde, disproportionné pour de la BI. Le deuxième billet de la série lui est consacré.
7. Microsoft Fabric (niveau C, avec une nuance)
La plateforme la plus poussée en France, portée par Power BI et le parc Microsoft 365. OneLake stocke en Delta Parquet et Microsoft expose un point d’accès REST compatible Iceberg, en lecture seule pour les métadonnées, mais le moteur, la tarification par capacité et la gouvernance via Purview vous ancrent dans l’écosystème Azure. À surveiller : Bleu, si sa qualification aboutit, pourrait un jour porter Fabric sur une infrastructure qualifiée. Ce n’est pas le cas aujourd’hui.
8. Google BigQuery (niveau C)
Entrepôt serverless, facturation à la requête, performances remarquables sur des volumes très importants. BigLake, rebaptisé Lakehouse for Apache Iceberg en avril 2026, sait lire des tables Iceberg, ce qui ouvre une porte, mais le moteur et la facturation restent captifs, et les coûts grimpent vite sur des requêtes fréquentes. Via S3NS, BigQuery figure au catalogue de services qualifiés SecNumCloud depuis décembre 2025, seul cas de ce comparatif ; le format natif reste propriétaire.
9. Amazon Redshift (niveau C)
Le choix naturel pour une organisation déjà sur AWS. Bonnes performances en traitement par lots, tarification réservée prévisible, lecture des tables Iceberg possible via Glue. Réglage manuel exigeant, mono-cloud, et aucune version souveraine annoncée en France.
10. Cloudera Data Platform (niveau A)
Le vétéran. Déployable sur site, bâti sur Hadoop, Spark, Impala, avec un support Iceberg natif depuis plusieurs versions. Complexe à exploiter, moins performant qu’un moteur cloud récent, mais c’est l’une des rares plateformes complètes qui tiennent dans un datacenter que vous maîtrisez.
11. PostgreSQL et ses extensions (niveau A)
Citus pour distribuer, TimescaleDB pour les séries temporelles, pg_duckdb / pg_lake pour l’analytique colonne. Souveraineté totale, coût de licence nul, compétences abondantes. En contrepartie, pas de séparation calcul-stockage et une limite d’échelle réelle au-delà de quelques téraoctets actifs. Pour un ministère ou une ETI qui n’a pas de pétaoctets, c’est souvent suffisant, et c’est souvent oublié.
12. StarRocks (niveau A)
Moteur analytique open source, hébergé par la Linux Foundation, conçu pour l’analyse multidimensionnelle en dessous de la seconde. Il lit Iceberg, Hive et Delta directement via des catalogues externes, parle le protocole MySQL. Projet plus jeune, communauté plus petite, mais c’est aujourd’hui l’un des moteurs les plus rapides sur des tables Iceberg pour du temps réel.
13. IOMETE (niveau A)
Absent de la liste originale, et pourtant c’est l’un des rares produits conçus dès le départ pour le cas que traite ce billet. IOMETE se présente comme un lakehouse packagé, construit sur Apache Iceberg, Apache Spark et Kubernetes, qui se déploie intégralement dans votre infrastructure : sur site, en cloud privé, chez un hébergeur souverain, ou en environnement totalement isolé du réseau. Selon l’éditeur, il n’opère aucun plan de données ; il fournit le logiciel, le catalogue REST Iceberg, le contrôle d’accès et la maintenance automatisée des tables, et peut détacher des ingénieurs pour exploiter le cluster si vous ne voulez pas le faire vous-même. Pour un ministère, un opérateur d’importance vitale ou un industriel de la défense, c’est la réponse « produit fini » à l’assemblage décrit au point 1, sans quitter le niveau A. Limites : éditeur jeune, communauté réduite, et une dépendance à Spark comme moteur principal qui appelle les mêmes remarques que pour Databricks.
Synthèse
| Outil | Format ouvert | Déployable chez un hébergeur qualifié | Modèle de coût | Lit Iceberg | Niveau |
|---|---|---|---|---|---|
| Iceberg + moteur au choix | Oui | Oui | Infrastructure seule | Natif | A |
| Trino / Starburst | Oui | Trino oui, Galaxy non | Gratuit / licence | Natif | A / B |
| ClickHouse | Oui | Oui (Scaleway) | Gratuit / managé | Oui | A / B |
| DuckDB / MotherDuck | Oui | Oui / non | Gratuit / abonnement | Natif | A / B |
| Dremio (sur site / cloud SAP BDC) | Oui | Sur site oui, cloud non | Licence | Natif | A / B |
| Databricks | Oui (Delta) | Non | Deux factures | Tables via Unity, vues non exposées | B |
| Microsoft Fabric | Partiel | Non (Bleu en cours) | Capacité | Lecture des métadonnées | C |
| Google BigQuery | Non | Oui, via S3NS | À la requête | Via Lakehouse for Apache Iceberg (ex-BigLake) | C, souverain via S3NS |
| Amazon Redshift | Non | Non | Réservé / à l’usage | Via Glue | C |
| Cloudera | Oui | Oui | Licence | Natif | A |
| PostgreSQL + extensions | Oui | Oui | Gratuit | Via extension | A |
| StarRocks | Oui | Oui | Gratuit | Natif | A |
| IOMETE | Oui | Oui (sur site, isolé possible) | Licence | Natif | A |
Le chemin, pas le grand soir
Ce qui suit est l’application de ce que nous appelons la souveraineté par les données : plutôt que de chercher un fournisseur de confiance, faire en sorte que chaque composant de l’architecture soit remplaçable. Le stockage, le format de fichier, le catalogue et le moteur sont quatre décisions distinctes, et Iceberg permet de les prendre séparément. C’est l’argument que nous avons développé à Subsurface 2025, et le pipeline CDC vers Iceberg montré en 2023 en était la première démonstration.
Personne ne quitte Snowflake un vendredi soir. Ce que nous proposons est une trajectoire en trois étapes, chacune utile en elle-même, chacune réversible.
Étape 1. Migrez vos tables Snowflake au format Iceberg, sur un stockage objet que vous contrôlez. Snowflake le permet, vous ne changez ni d’outil ni d’équipe. Vous venez de passer du niveau C au niveau B.
Étape 2. Branchez un second moteur en lecture sur ces tables. Trino ou DuckDB, peu importe. L’objectif est de prouver, avec des requêtes réelles, que vous pourriez remplacer Snowflake. Cette preuve change le rapport de force à la prochaine négociation de contrat.
Étape 3. Pour les données que la doctrine de l’État classe comme sensibles, ou qu’un client exige chez un hébergeur qualifié, déplacez le stockage chez un prestataire qualifié SecNumCloud. Pour une entité financière, DORA n’impose pas d’héberger en France : il impose une stratégie de sortie documentée (article 28, paragraphe 8), dont ce second moteur est la meilleure preuve. Le reste peut rester où il est. La souveraineté se décide donnée par donnée.
À chaque étape, la donnée circule une seule fois. Un flux CDC depuis vos applications, une table Iceberg, et autant de moteurs que d’usages. C’est ce que nous appelons l’intégration en un seul passage, et c’est ce qui rend cette trajectoire économiquement tenable.
Cinq questions à poser à votre DSI cette semaine
- Quelle part de nos tables Snowflake est aujourd’hui au format Iceberg, sur un stockage que nous contrôlons ?
- Combien de temps et combien d’euros faudrait-il pour relire nos données avec un autre moteur, demain ?
- Avons-nous une stratégie de sortie documentée pour Snowflake (article 28 de DORA si nous sommes une entité financière), et quelles données relèvent de la doctrine de l’État sur les données sensibles, hébergées chez qui, sous quelle juridiction ?
- Notre dernier contrat Snowflake a-t-il été négocié avec une alternative crédible sur la table ?
- Si notre fournisseur était racheté demain, qu’est-ce qui, dans notre architecture, dépend de ses intentions plutôt que d’un standard Apache ?
La cinquième question est celle qui compte. Ne pariez pas sur les intentions de l’éditeur. Pariez sur la gouvernance du format.
Sources
- Snowflake, communiqué de résultats du T4 de l’exercice 2022, 2 mars 2022 (rétention nette de 178 % au 31 janvier 2022) : https://www.snowflake.com/en/news/press-releases/snowflake-reports-financial-results-for-the-fourth-quarter-and-full-year-of-fiscal-2022/
- Snowflake, documentation Access Apache Iceberg tables with an external engine through Snowflake Horizon Catalog (tables gérées par Snowflake seulement ; facturation de l’API) : https://docs.snowflake.com/en/user-guide/tables-iceberg-access-using-external-query-engine-snowflake-horizon
- Légifrance, Arrêté du 12 août 2026 portant approbation du référentiel d’exigences relatif aux prestataires de services d’informatique en nuage : https://www.legifrance.gouv.fr/jorf/id/JORFTEXT000054678082
- Charly Clairmont (Synaltic), Escaping the Hadoop Trap: Apache Iceberg, the long-term technical debt shield, Subsurface 2025, https://youtu.be/0buykj29KbY
- Cigref, Stratégies de migration dans le cloud : un défi structurant pour l’entreprise, janvier 2023, 65 p. Chapitre 5 (approche financière, p. 33-38). https://www.cigref.fr/wp/wp-content/uploads/2023/01/Rapport\_Strategies\_de\_migration\_dans\_le\_cloud\_Janvier\_2023\_vf.pdf Le rapport contient aussi un retour d’expérience de Système U (p. 62), qui a comparé BigQuery et Snowflake avant de choisir Google, en partie parce que sa plateforme repose sur des standards open source, PostgreSQL notamment, ce qui laisse ouvertes des possibilités de repositionnement.
- Maplebear Inc. (Instacart), Form S-1, SEC, août 2023, section « Related Party Transactions » ; The Register, Snowflake explains that Instacart’s bills aren’t melting – it’s called ‘optimization’, 31 août 2023, https://www.theregister.com/2023/08/31/snowflake\_instacart\_payments/
- Snowflake Inc., Form 10-Q pour le trimestre clos le 31 octobre 2025, SEC, sections « Risk Factors » et « Key Business Metrics », https://www.sec.gov/Archives/edgar/data/1640147/000164014725000211/snow-20251031.htm
- Dremio, Snowflake Competitors: More Affordable and Open Source Alternatives, mai 2026.
Prochain billet : Delta Lake est open source. Databricks ne l’est pas.

Sections commentaires non disponible.